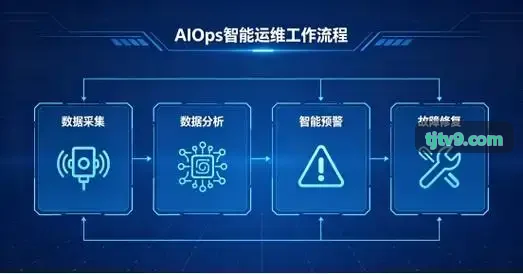
全流程软硬件协同设计与仿真工具流
打破传统半导体研发中软硬件团队割裂的壁垒,建立从算子级图优化到底层硅物理特性的严密映射链条。全面兼容 RISC-V 扩展指令集与 PCIe 5.0/CXL 2.0 互联标准,支持主流晶圆代工厂 7nm/5nm 工艺 PDK 参数包,仿真精度达成 99.8% 实测对齐。
分层工具链解耦架构
支持算法计算图下发、统一中间表示(IR)转换、微码生成与周期级硬件事务监控实时同屏交互。
上层异构算子融合与代码生成器
提供针对Transformer与各类CNN计算图的自动分块、切分及内存复用优化策略,屏蔽硬件拓扑复杂度,生成无死锁微码指令。
Cycle-Accurate 周期精确微架构仿真核
精细建模脉动阵列、片上网络(NoC)、高带宽显存(HBM3)及共享SRAM的读写竞争与延迟波形,硅前真实反馈微架构性能瓶颈。
自动化约束分析与PDK物理参数校准
内置国际主流代工厂标准工艺库单元延迟与漏电模型,在RTL级提前进行静态时序分析(STA)与热功耗包络动态预估。
赋能高复杂度半导体项目的六维核心优势
J9不仅是一套建模系统,更是沉淀了数十次先进工艺流片实操经验的工程加速器,全方位保障算力产品按期交付。
架构级周期精确仿真
自研多核分布式仿真器,支持数百核规模异构阵列在时钟周期级精度下的指令互锁、总线拥塞与缓存命中率仿真。
软硬件协同编译优化
打通PyTorch与ONNX前端,自研底层IR具备多级图分块与数据搬运并行流水线生成能力,算子利用率高达88%以上。
大规模集群云端 EDA 调度
基于弹性容器与专用硬件集群的混合调度架构,支持数千节点高并发回归测试,极速推进大规模逻辑覆盖率达标。
自动化回归与断言验证
内建上万套工业标准算子测试向量库,自动化注入异常死锁、内存越界与总线故障,实现RTL级别Bug极高概率提前捕获。
混合精度算力功耗深度建模
针对FP8、BF16、INT4等量化数据类型的脉冲功耗与电压跌落进行深度拟合,助力封装设计与散热架构提前锁定边界。
硅后 Bring-up 实验室远程协同
提供从裸片点亮(Bring-up)到驱动加载的远程示波器、逻辑分析仪与JTAG联合调试环境,加速原型板级系统调通。
针对典型算力场景的标准研发套件矩阵
模块化设计让架构师团队能够根据终端产品功耗预算与能效比要求,灵活选配微架构IP核心与自动化编译流水线。
边缘端轻量级 NPU 研发平台
主打超低功耗与边缘智能视觉加速
- 算力范围 1.5 - 8.0 TOPS (INT8)
- 典型功耗预算 < 2.5W 封装功耗
- 内存接口 LPDDR4x / eMMC 5.1
- 工艺适配 28nm / 22nm ULP
数据中心级异构训练芯片模拟器
面向大模型预训练与超大规模集群互联
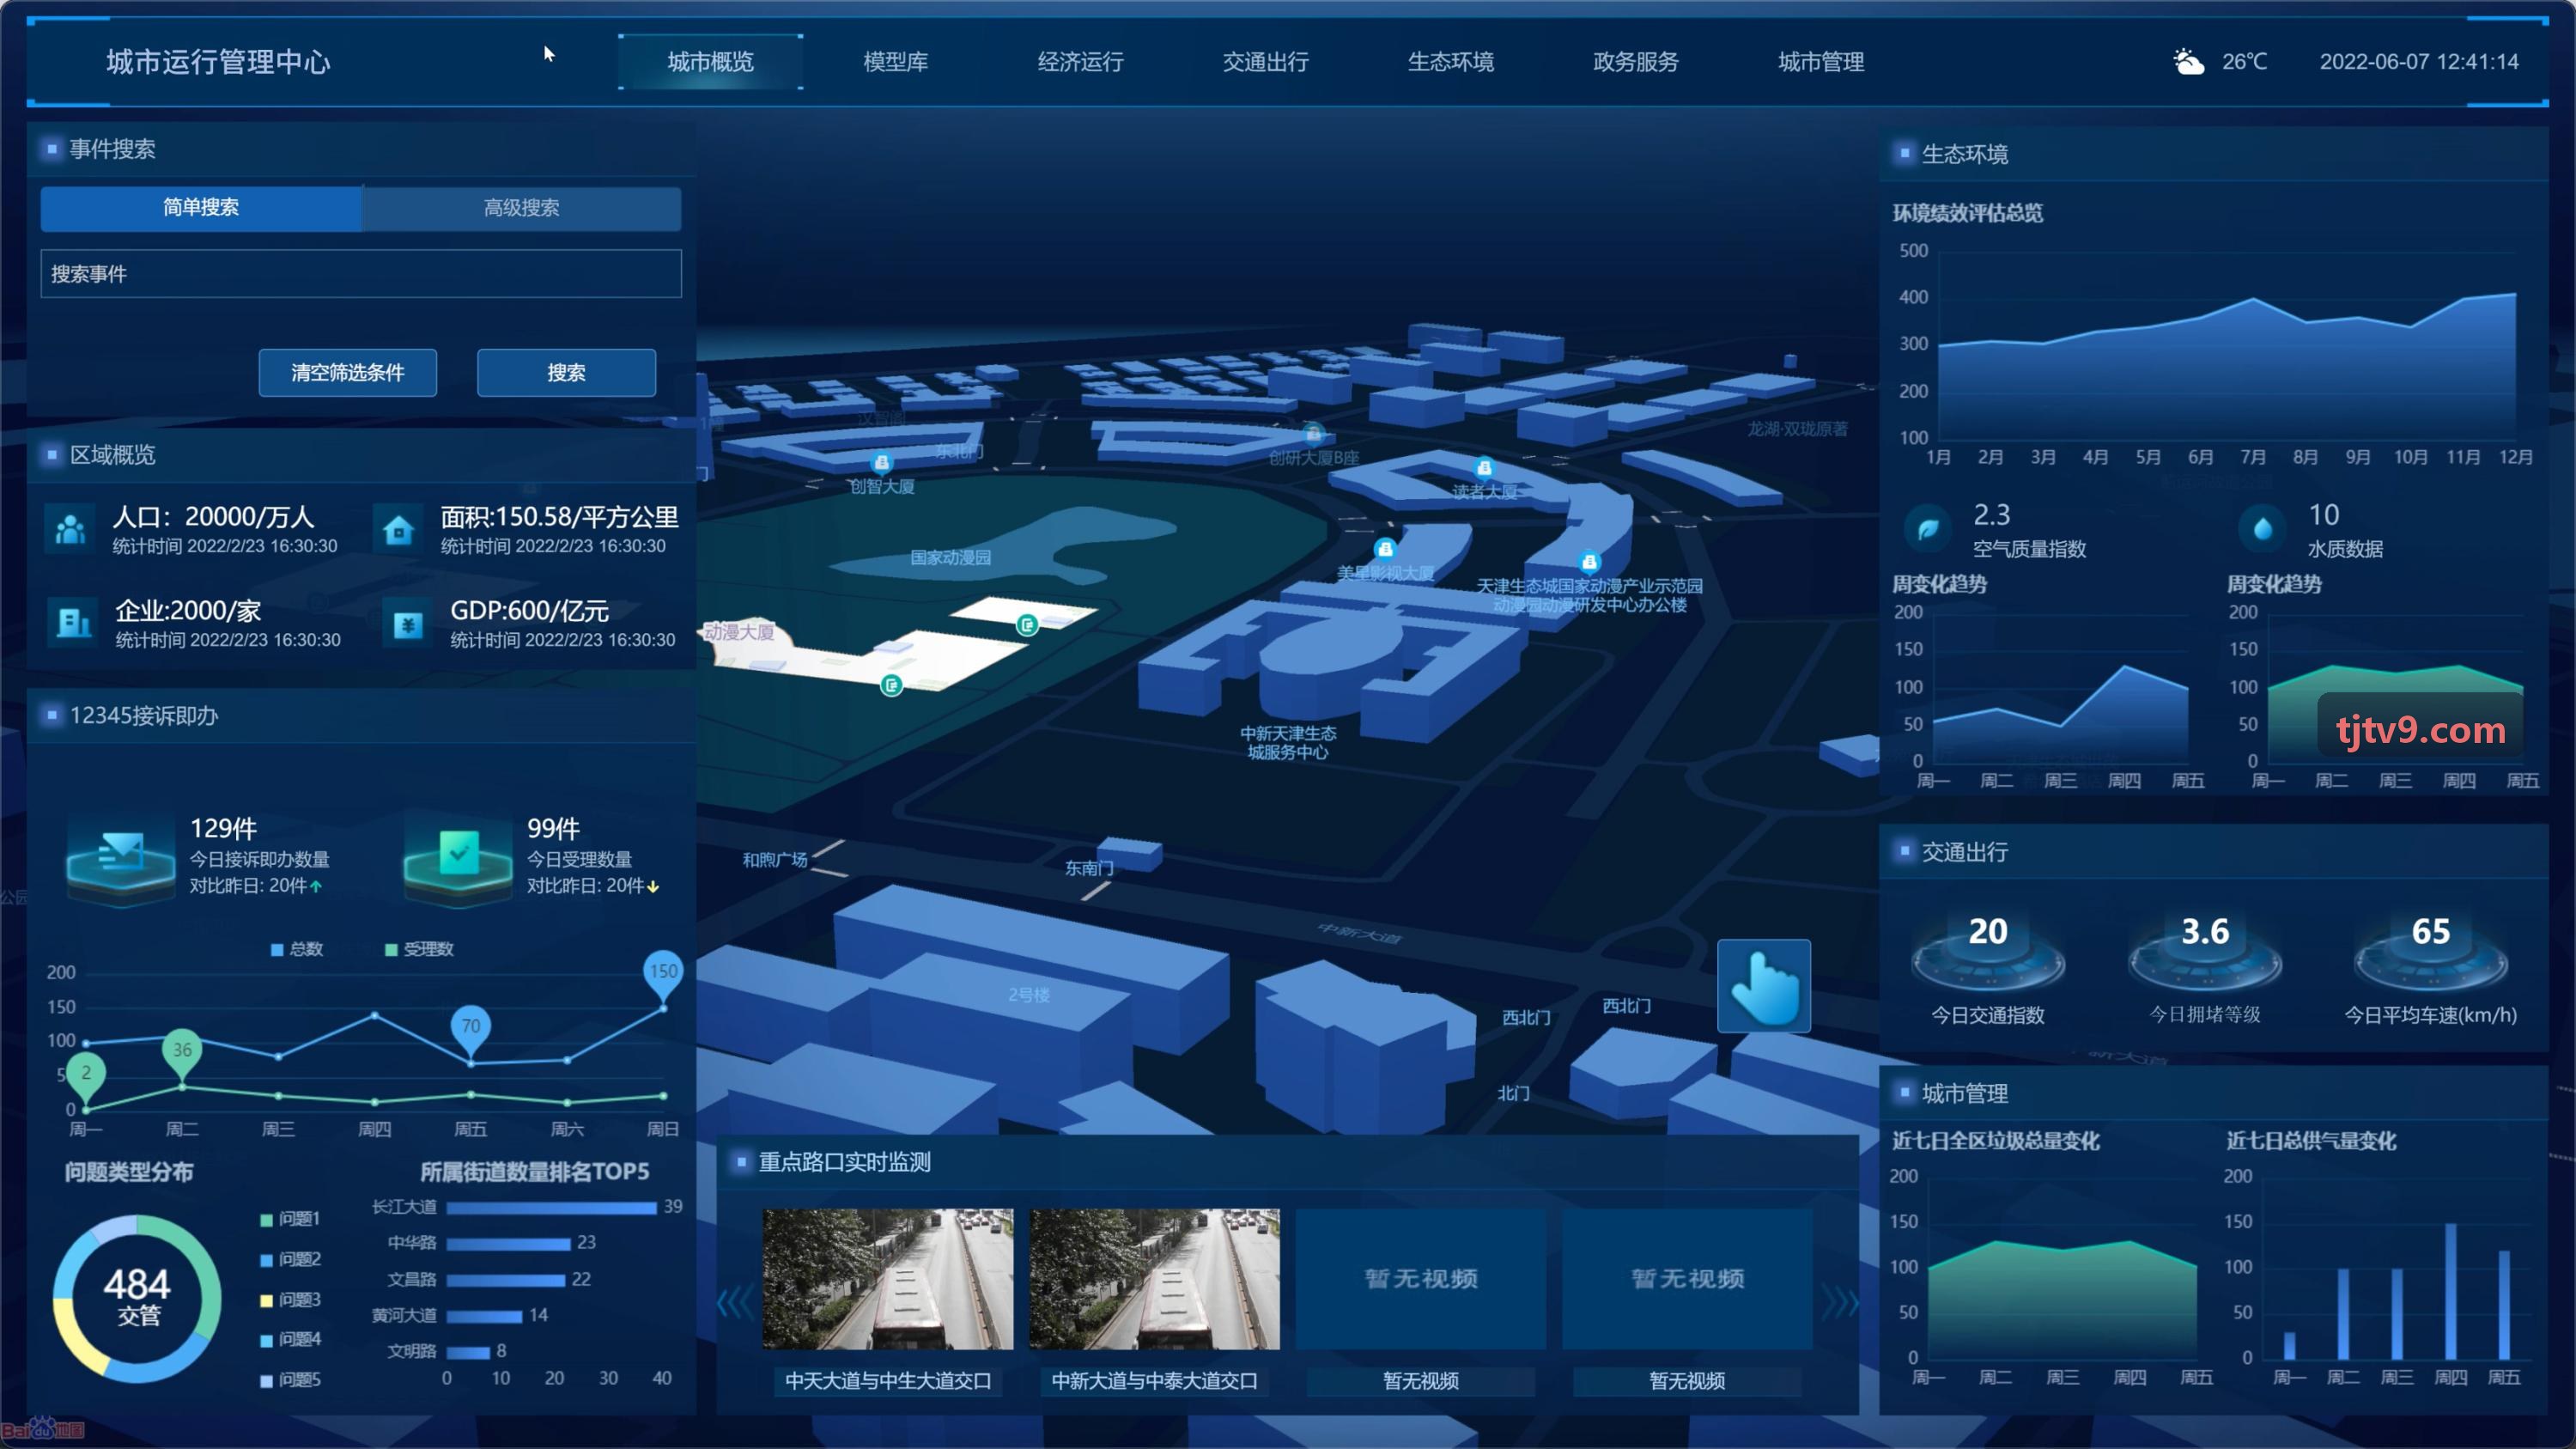
- 算力标称 512 - 2048 TFLOPS (FP16/BF16)
- 互联带宽 PCIe 5.0 x16 / CXL 2.0 / 400G RoCE
- 显存拓扑 HBM3 3.2TB/s 级总线
- 工艺适配 7nm / 5nm 先进封装 (Chiplet)
车规级高安全算力验证一体机
满足ISO 26262 ASIL-D功能安全要求
- 综合算力 120 - 450 TOPS 密集矩阵
- 冗余机制 锁步双核(Lockstep)+ ECC 全总线
- 功能安全等级 ISO 26262 ASIL-D 级验证覆盖
- 工艺适配 16nm / 7nm 汽车级车规工艺
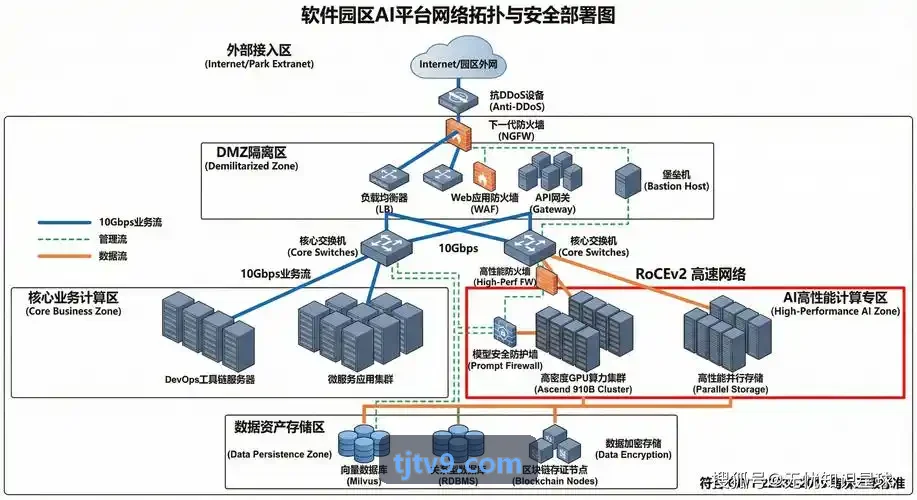
突破“算力墙”与“内存墙”:从单点加速到体系级协同演化
大模型时代的算力瓶颈已从单纯的MAC算力堆叠,转移至片上网络延迟、显存搬运功耗及指令调度开销。J9倡导软硬件联合设计范式,在算法模型研发初期即介入微架构空间探索,通过算子编译流与硬件流水线的深度协同,消除总线等待气泡,将传统流片前的仿真死锁排查耗时降低至传统方案的三分之一。
硅前效能评估模型实测指标
一线芯片工程团队真实落地成果
从云端AI训练集群核心芯片到车载高等级自动驾驶控制器,J9为客户团队提供可量化、高可靠的工程落地支撑。
大语言模型专用推理芯片架构探索与首发验证
该团队面临注意力机制动态稀疏算子在硬件中利用率低下及内存墙瓶颈。平台介入后,利用周期精确模拟器完成8种拓扑架构的快速对比,自研算子融合编译器将稀疏KV-Cache搬运开销降低41%。该项目仅用时8个月即完成全部RTL交付,回片后两周内成功点亮,算力能效比超越既定设计目标18%。
多传感器融合高实时算力核功能安全闭环设计
客户团队需满足严苛的ASIL-D功能安全冗余验证,传统的单核仿真难以覆盖微秒级硬件故障注入场景。平台提供车规级验证一体机环境,自动运行超过3,200个故障注入场景,在逻辑综合前成功捕获4处总线死锁隐患,全面缩短第三方安全认证审计周期达5个月。
半导体总监与系统架构师实测评价
听听身处芯片研发一线的工程带头人,如何借助平台工具链攻克异构计算的复杂工程难题。
“在过去,做一套自定义张量指令集需要在软件驱动和微架构仿真之间反复打架。J9直接打通了从中间表示到Cycle-Accurate模拟器的闭环,我们的架构选型时间直接从四个月缩短到三周。”
“云端大规模分布式EDA调度能力令人印象深刻。几万条复杂断言在平台集群上几乎是准实时回归,帮助我们在流片前锁定了三个极其隐蔽的NoC多核死锁条件,为项目挽回了数千万元的潜在重流风险。”
“针对边缘嵌入式NPU,能效比就是生命线。平台的功耗深度拟合模型与实测回片数据吻合度惊人,我们能够在物理版图布线前精准剪裁SRAM位宽,真正做到了按图索骥交付极致低功耗芯片。”
技术白皮书与半导体工程动态
深入探索现代算力架构、互联通信标准演进与先进封装流片验证的硬核技术沉淀。
基于 PCIe 5.0 与 CXL 2.0 的异构大算力池化验证实践
解析如何在J9中搭建低延迟内存共享总线拓扑,克服多处理器之间Cache一致性协议复杂度的工程挑战。
RISC-V 矩阵扩展(Vector/Matrix)硬件高效解码设计
详细探讨在开放标准架构下,如何设计高流水线复用率的矩阵运算单元,平衡译码级延迟与执行单元吞吐率。
Chiplet 芯粒互联在千卡训练芯片中的硅前验证方法
围绕UCIe与Die-to-Die互联接口,阐明高密度互连线网信号完整性仿真与硅中介层(Interposer)热应力联合仿真方法论。
开发者与芯片工程常见问题
解答关于平台与主流商业EDA环境兼容性、私有集群部署和底层知识产权托管的核心关切。
平台如何与主流第三方商业 EDA 工具链实现协同? +
是否支持本地私有化数据中心与纯内网集群离线部署? +
FPGA 原型验证与仿真加速器硬件是如何接入的? +
在芯片设计各阶段,平台如何确保企业知识产权(IP)与代码安全? +
平台自研编译系统对前沿算法模型(如MoE结构)的跟进速度如何? +
7×24小时现场 FAE 支撑
资深微架构与流片工程师随时待命,重大流片节点提供驻场级保障,快速排查死锁与时序收敛瓶颈。
工业级 IP 隔离防护
物理级独立租户存储体系,通过严苛的半导体供应链知识产权安全认证,确保数字资产绝对私密。
全链路版本溯源存证
从算法配置参数到门级网表变更完整记录操作快照,满足ISO质量体系合规审计与回归复现。
长周期工具链兼容承诺
提供核心编译系统与微架构仿真核长达5年的长期技术支持(LTS),确保持续流片迭代无断层。
跨晶圆代工与基础开源计算生态协同
平台深度联通主流 Foundry 代工厂、微电子国家重点实验室与开放指令集组织,构建繁荣的技术工程联合体。
立即接入 J9 开启全流程工程验证
填写项目基本参数,我们的资深半导体架构师与编译器工程专家将在 1 个工作日内与您取得联系,为您开通定制化的云端 EDA 仿真集群账号或安排本地化环境试用。